
一、老大难:每个项目都在"重新教一遍系统"
结构健康监测行业有一条不成文的规律:换一个项目,就要重做一遍算法。
阈值要重新定——同样是主梁竖向挠度,斜拉桥与悬索桥的正常波动范围能差出一个数量级;特征要重新选——温度是协变量还是噪声,取决于桥型、朝向和当地气候;模型要重新训——上一个项目积累的异常样本,到了新桥上几乎全部失效。行业里做报警配置的工程师自嘲是"给每座桥重新养一个孩子":上线后先放任误报两三个月,人工标注、收紧阈值,系统才慢慢"懂事"。
某省级桥梁监测平台的统计颇具代表性:全省三百多座桥梁接入同一平台,预警规则却按项目各自维护,累计阈值条目超过四万条;每年因环境变化、传感器更换导致的阈值失效率在 15% 以上,需要专人逐条复核。算法工程师的时间,大半耗在"搬一个项目、调一遍参数"上。
这背后的根本原因是:传统异常检测是"判别式"的——它只见过某一类桥、某一频段的数据,泛化能力天然有限。而近几年时序基础模型的进展,正在把这个前提改写。
二、时序基础模型:从"逐库建模"到"拿来就用"
时序基础模型的思路,与 ChatGPT 在文本领域的路径如出一辙:先在海量、异构的通用时序数据上做大规模预训练,让模型学会"时间序列的通用语法"——趋势、周期、突变、季节性叠加;到了具体任务上,不再从零训练,而是零样本(zero-shot)直接推理,或者只用少量目标域数据微调。
这一赛道在 2024~2026 年快速收敛出几个代表性模型:Google 的 TimesFM(第二代已支持变长输入与解码式预测)、Amazon 的 Chronos(把数值离散化为 token 用语言模型架构处理)、Salesforce 的 Moirai(支持多变量与任意采样频率),以及面向工业场景的 moment、UniTS 等。公开基准上,这些模型在未见过的数据集上做零样本预测,精度已经接近甚至超过在该数据集上从头训练的专用模型。
对监测行业而言,这个变化的意义不在"精度提升几个点",而在范式转变:模型的"知识"来自预训练阶段见过的千万条通用时序,而不是某个项目标注过的异常样本。换一座桥,模型不再是"白纸",而是一个已经懂得温度日周期、交通荷载波动、传感器漂移长什么样"的通用底座——项目上要做的,只是让它认识这一座桥的个性。
三、在结构监测里,它到底能干三件事
第一件:补缺失与去异常,把"数据治理"自动化。 监测数据天然残缺:供电中断、通信抖动、雷击坏点,让长序列缺洞是常态。传统做法靠插值和人工清洗,规则写不胜写。基础模型本质上是概率预测器,给它断口前后的片段,它能输出符合该桥"习惯"的补全分布,同时把"长得不像这台传感器会产生的值"标记为疑似异常。实测中,对小时级均值序列的补全误差通常能控制在人工经验插值的八成以内,而工作量接近于零。
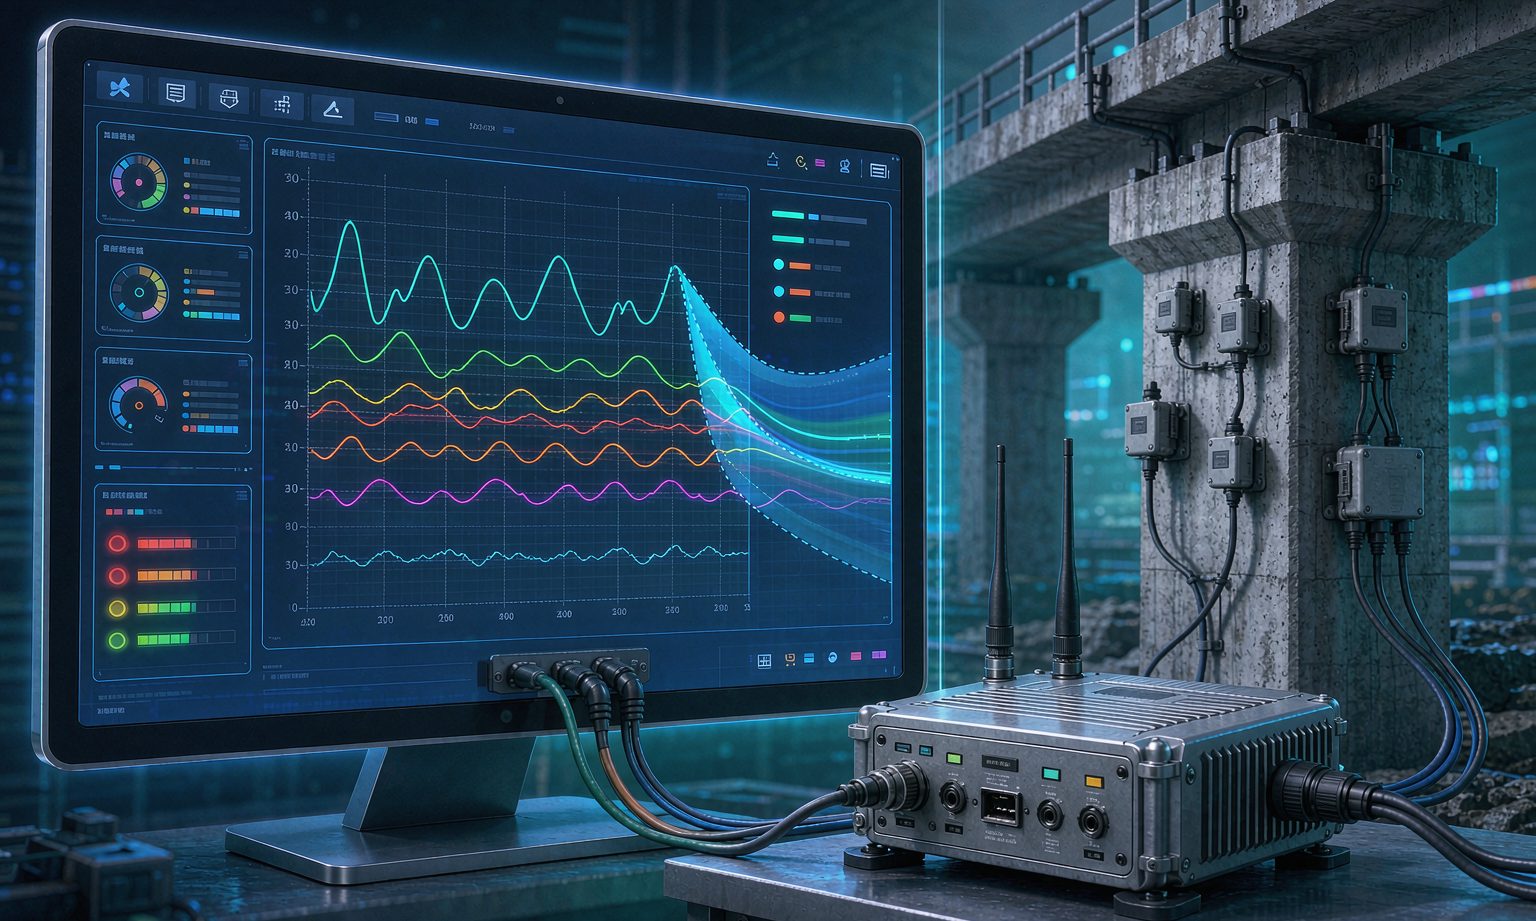
第二件:预测式异常评分,替代静态阈值。 这是最有想象力的用法。模型持续输出"下一时刻应该是什么"的预测区间,实测值落在区间外就累积一个异常分数。它和静态阈值的本质区别在于"知道语境":夏天午后挠度到 80 毫米可能是正常的温度效应,初冬凌晨出现同样数值就值得警惕——传统阈值规则写不出这种上下文敏感性,基础模型天然自带。行业初步实践显示,这类方法在交通荷载主导的挠度、倾角通道上,能把误报率压低一半以上,同时不漏掉真正的趋势性异常。
第三件:趋势外推,从"报警"走向"预告"。 把模型输出的预测区间拉长到天、周尺度,可以观察实测值与预测轨迹的持续偏离。当残差连续多日单边漂移,往往意味着支座卡滞、徐变加速或基础沉降这类缓变病害。这种"预告式"判据不追求精确诊断,而是给养护方争取时间窗口——比达到告警阈值后再处置,平均能提前数周。
四、一个桥梁群的真实落地账
2025 年起,某沿海城市将时序基础模型引入其 47 座在役桥梁的集中监测平台,给出了一个可参考的落地样本:
- 部署形态:平台侧集中推理。47 座桥约 2.1 万个测点的分钟级数据汇入平台,基础模型以批处理方式对每条通道滚动输出预测与异常评分,单张消费级 GPU(24GB 显存)经量化后即可支撑全量通道的日级推理;
- 冷启动速度:新桥接入不再需要两三个月的"调参磨合期"。模型零样本输出的异常评分,配合两周的目标数据微调,即可达到人工调参三个月后的稳定水平,新桥上线到告警可信的周期从约 90 天缩短到 20 天以内;
- 误报治理:以挠度、倾角、索力三类通道试点,与原静态阈值体系并行运行 6 个月,基础模型路线的日误报量约为原体系的 40%,而试点通道未发生漏报;
- 成本结构:平台侧投入主要是两台 GPU 服务器与一名算法工程师的维护工时,摊到 47 座桥上的单桥年均成本不足传统"逐项目定制算法"外包费用的十分之一。
这笔账的关键在于规模效应:传统模式下算法成本随桥数线性增长,基础模型模式下增长的主要是推理算力,边际成本曲线明显更平。桥越多,越划算。
五、难啃的骨头:领域差距、高频数据与边缘算力
把这项技术讲成"包治百病"是不负责任的。落地中有三道坎,目前都有人跨,但都不轻松。
领域差距是第一道坎。 预训练语料以金融、能源、交通类的通用时序为主,结构监测数据有自己的"脾气":强温度协变量、潮汐周期、车辆荷载的脉冲结构,在通用语料中并不占主导。零样本性能在通用数据上惊艳,搬到结构数据上通常要打折扣,因此务实的路线是"零样本打底 + 目标域微调",完全跳过微调的项目目前还不多。
高频数据是第二道坎。 基础模型原生擅长的是秒到小时级的中低频序列,而动应变、加速度通道动辄百赫兹、上千赫兹。直接喂原始高频流不现实,行业做法是两级架构:边缘侧做特征提取(RMS、峰值、频带能量),把高频降为分钟级特征序列再进基础模型。这意味着高频通道的精细损伤识别,短期内仍是传统信号处理与专用模型的天下。
边缘算力是第三道坎。 平台侧集中推理没有算力障碍,但很多场景要求"断网也能判"——隧道、山区桥梁的通信回传并不总是可靠。把量化后的基础模型塞进边缘网关正在变得可行:4-bit 量化后的小型时序模型,在带 NPU 的工业网关上已能跑到秒级推理,但多通道并发、模型更新分发、边缘与云端评分的一致性校准,都还是工程上的精细活。
六、落地清单:怎么判断该不该上
结合已有项目经验,评估要不要引入时序基础模型,建议盯住五点:
- 先看规模。 十座桥以下的业主,传统阈值加规则引擎调教成熟后未必需要基础模型;几十座桥以上的集中平台,规模效应才开始显现。
- 数据质量先过关。 模型补缺失的能力再强,也补不了长期缺测、时钟错乱的数据。先把采集完整率做到 95% 以上再谈智能化。
- 架构上留双轨。 基础模型评分与既有静态阈值并行运行至少一个汛期和一个完整冬夏,用真实误报/漏报数据决定切换节奏,不要"一刀切"。
- 可解释性要跟上。 给养护人员看的不该只是一个分数,还要有"预测区间与实测的偏离图"这类可目视核对的证据,否则告警永远不会被信任。
- 明确它不做什么。 承载力评估、损伤定位这类需要力学机理支撑的任务,仍属于传统有限元与专用方法的范畴,基础模型是"感官放大器",不是替代诊断的医生。
七、总结
时序基础模型带来的,本质上是把结构监测的算法成本从"线性重复投入"变成"一次预训练、处处低成本复用"。补缺失、替代静态阈值、趋势外推这三件事已经跑通,误报减半、冷启动周期缩短七成以上的实测数据,足以支撑中型以上平台认真评估这项技术。
但它不是银弹:高频通道与精细诊断仍在传统方法手里,边缘部署与可解释性是需要持续投入的工程问题。未来两三年的看点有两个:一是结构监测领域自己的预训练语料库能否形成——谁先攒出跨桥型、跨地域的大规模标注数据,谁就掌握下一代平台的主导权;二是基础模型与物理机理模型的融合,让统计预测与力学约束互相校验。对行业而言,"每座桥重新养一个孩子"的时代,可能真的开始进入倒计时了。